Chercher une données personnelles définition fiable et exhaustive constitue le premier pas indispensable pour garder la maîtrise de ses traces numériques face aux collectes automatisées des acteurs du web. Ce dossier explique avec précision les critères légaux distinguant une simple information d’une donnée protégée, tout en exposant les enjeux économiques et sécuritaires liés à leur utilisation massive. Vous disposerez ainsi des clés de compréhension nécessaires pour identifier les risques invisibles et mobiliser les droits garantissant la sécurité de votre vie privée. 🛡️
- Définition fondamentale : qu’est-ce qu’une donnée personnelle ?
- Le spectre des données : des informations évidentes aux identifiants cachés
- L’art du recoupement : comment l’identification indirecte fonctionne
- Données sensibles : une catégorie sous haute protection
- Le cadre légal : pourquoi protéger nos informations est un enjeu majeur
- Les grands principes du traitement des données
- Les données personnelles, nouvel or noir de l’économie numérique
- Vos droits et les risques : maîtriser son identité numérique
- Comment protéger efficacement ses données personnelles au quotidien ?
Définition fondamentale : qu’est-ce qu’une donnée personnelle ?
La définition légale au cœur du système
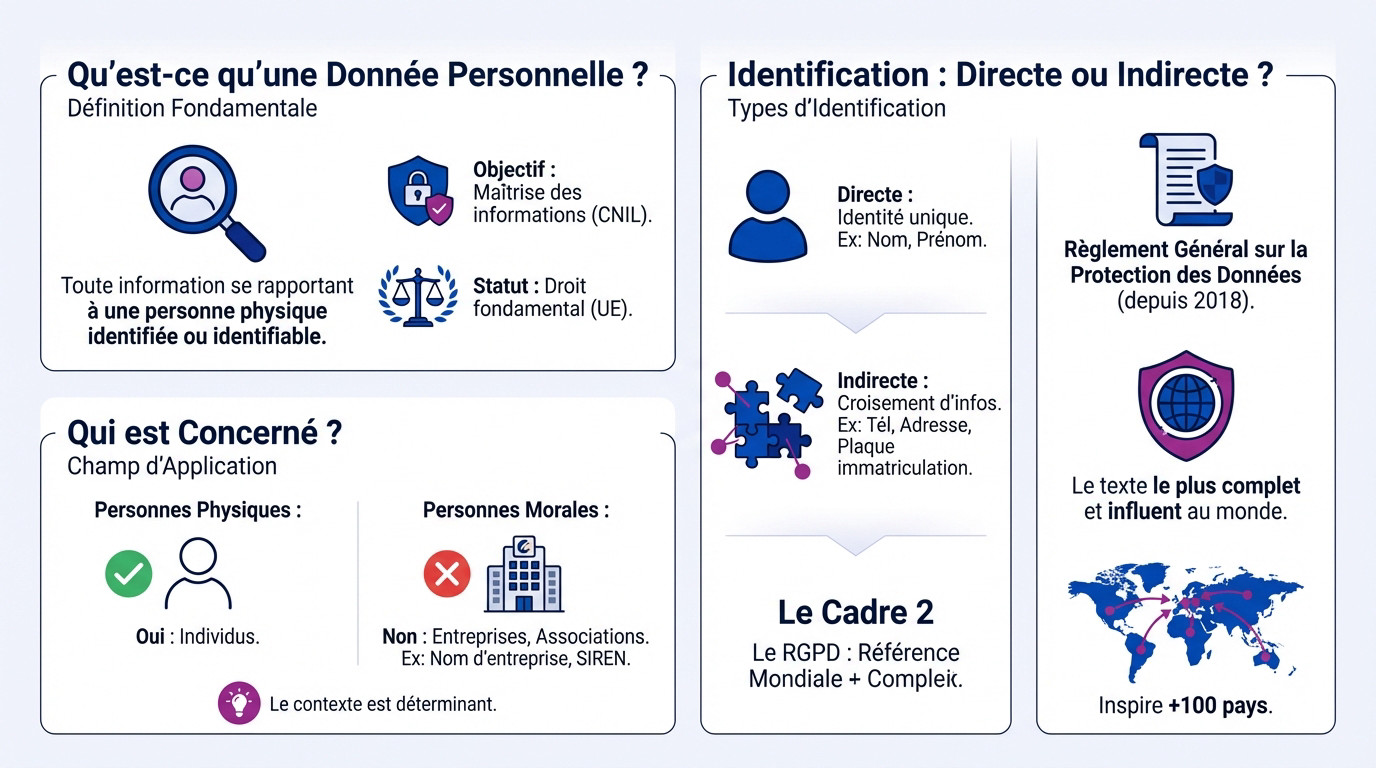
Pour aborder la données personnelles définition exacte, le texte désigne toute information se rapportant à une personne physique identifiée ou identifiable. Cette notion large constitue la pierre angulaire de la protection de la vie privée dans notre environnement numérique.
L’objectif vise à permettre à chacun de conserver la maîtrise de ses informations. C’est un point souligné selon la CNIL pour garantir le respect des droits individuels et assurer une transparence nécessaire.
Cette protection représente un droit fondamental reconnu en Europe, indissociable du respect de la vie privée, tel que ce droit fondamental consacré par l’Union Européenne.
Identification directe ou indirecte : une distinction essentielle
L’identification directe désigne une information qui, seule, permet de connaître l’identité d’une personne sans ambiguïté. Les exemples les plus parlants restent le nom et le prénom d’un individu dans un fichier.
L’identification indirecte est plus complexe. Une personne devient « identifiable » lorsque plusieurs informations, une fois croisées, permettent de remonter jusqu’à elle. On pense ici à un numéro de téléphone, une adresse postale, ou une plaque d’immatriculation 🚗.
Le contexte reste donc déterminant pour savoir si une donnée spécifique permet d’identifier quelqu’un avec certitude.
Le cas des personnes morales : une exclusion importante
Il faut préciser que la notion de donnée personnelle ne s’applique juridiquement qu’aux personnes physiques, c’est-à-dire aux individus vivants.
À l’inverse, les informations concernant les personnes morales, comme les entreprises, associations ou fondations, sortent de ce cadre. Leur nom, leur adresse de siège social ou leur numéro SIREN ne sont pas considérés comme des données personnelles au sens du règlement 🏢.
Le RGPD : un cadre de référence mondial
Le Règlement Général sur la Protection des Données (RGPD) s’établit comme le texte de référence en Europe depuis 2018. Il se définit comme une législation moderne, spécifiquement adaptée aux défis de l’ère du numérique.
Ce règlement est souvent perçu comme le texte le plus complet au monde sur ce sujet, influençant les lois bien au-delà des frontières de l’UE.
Plus de 100 pays disposent aujourd’hui de lois sur la protection des données, souvent inspirées par ce modèle, comme l’indique l’analyse sur plus de 100 pays.
Le spectre des données : des informations évidentes aux identifiants cachés
Les données d’identité classiques
Lorsqu’on cherche une données personnelles définition, on pense d’abord à l’état civil. Le nom, prénom, âge, genre, ou la date de naissance constituent le socle de l’identification directe. 🪪
Viennent ensuite les éléments permettant de contacter un individu. L’adresse postale, l’adresse e-mail et le numéro de téléphone sont indispensables. Ces informations figurent systématiquement au cœur des formulaires administratifs ou commerciaux, en ligne comme hors ligne.
Les traces numériques : des identifiants techniques
L’activité sur le web génère des traces moins visibles mais tout aussi identifiantes. L’adresse IP, qui identifie la connexion internet d’un appareil, représente l’exemple technique le plus courant🌐.
D’autres marqueurs s’ajoutent à cette liste, notamment les identifiants de cookies déposés sur les navigateurs. On retrouve aussi l’identifiant publicitaire des smartphones (IDFA ou GAID) et l’adresse MAC unique de chaque carte réseau.
Bien que ces suites de caractères paraissent abstraites, elles permettent de remonter à un utilisateur précis. Elles restent donc protégées par la réglementation.
Données physiques et comportementales
Les informations liées aux caractéristiques physiques relèvent également de cette catégorie. Une simple photo, un enregistrement de la voix ou une vidéo de surveillance où l’individu est reconnaissable constituent des données personnelles à part entière. 📸
Cela inclut les données biométriques spécifiques, telles que les empreintes digitales ou les dispositifs de reconnaissance faciale.
L’analyse s’étend désormais aux comportements. Les données de localisation via GPS, l’historique de navigation web ou les habitudes d’achat tracent un profil précis de l’utilisateur.
Exemples de données personnelles du quotidien
Pour mieux saisir l’ampleur de la collecte, voici une liste d’éléments courants. Cette visualisation permet de comprendre à quel point ces informations imprègnent notre vie quotidienne.
- Un numéro de sécurité sociale ou un numéro de passeport.
- Des coordonnées bancaires comme un IBAN ou un numéro de carte.
- Une plaque d’immatriculation de véhicule.
- Des résultats d’évaluation ou des notes scolaires.
- Un historique de connexion précis à un service.
- Des informations issues des réseaux sociaux, incluant publications et « likes ».
- Des données de santé issues d’une application de bien-être.
L’art du recoupement : comment l’identification indirecte fonctionne
Comprendre la liste des données est une chose, mais le véritable enjeu se situe souvent dans leur combinaison. C’est là que la notion d’identification indirecte prend tout son sens. Cette section explore comment des informations apparemment anodines peuvent, ensemble, nous identifier.
La puissance du croisement de données
Pour bien cerner la donnée personnelle, sa définition ne s’arrête pas au nom. Le vrai pouvoir réside dans le croisement d’informations. Une indication isolée, comme « vit à Paris », reste vague. Mais combinée à d’autres, le cercle se resserre dangereusement. 🔍
Prenons un cas concret inspiré de la CNIL : une femme, vivant à une adresse précise, née tel jour, et membre d’une association spécifique. Pris séparément, ces éléments sont faibles. Combinés, ils ne désignent probablement qu’une seule personne. C’est un exemple souvent cité pour illustrer la fragilité de l’anonymat.
Pseudonymisation : un masquage souvent réversible
La pseudonymisation opère un remplacement stratégique. On substitue une donnée identifiante, comme un nom, par un code neutre type « Client_12345 ». L’identité immédiate s’efface derrière cet alias technique.
L’objectif est de réduire les risques en cas de fuite de la base de données principale. Sans la clé de correspondance, l’information n’est plus directement lisible pour un tiers.
Attention, les données pseudonymisées restent des données personnelles car il est toujours possible de ré-identifier la personne en utilisant une table de correspondance sécurisée. 🛡️
Anonymisation : la rupture du lien
L’anonymisation est bien plus radicale. Ce traitement modifie les structures de sorte qu’il soit impossible de manière irréversible de retrouver la personne. Le lien technique est définitivement rompu.
Les méthodes varient : flouter des visages sur une photo, supprimer complètement les noms ou agréger les données à un niveau statistique élevé. ✂️
Seules les données correctement anonymisées sortent du champ d’application du RGPD, car elles ne concernent plus personne.
Comparatif : anonymisation vs. pseudonymisation
Pour clarifier ces deux notions techniques mais fondamentales, un tableau comparatif est l’outil le plus efficace. Il permet de visualiser rapidement les différences et d’éviter les confusions juridiques.
| Critère | Pseudonymisation | Anonymisation |
|---|---|---|
| Objectif | Réduire le risque en masquant l’identité | Rendre l’identification impossible |
| Réversibilité | Oui, le lien avec la personne peut être rétabli | Non, le processus est irréversible |
| Statut légal | Reste une donnée personnelle (soumise au RGPD) | N’est plus une donnée personnelle (hors RGPD) |
| Exemple technique | Remplacer « Jean Dupont » par « Utilisateur #A4B8 » | Agréger les données : « 54% des utilisateurs ont plus de 30 ans » |
Données sensibles : une catégorie sous haute protection
Toutes les données personnelles ne se valent pas en termes de risque pour les individus. Certaines informations sont si intimes qu’elles bénéficient d’une protection renforcée. Ce sont les fameuses « données sensibles« . 🛡️
Qu’est-ce qu’une « donnée sensible » ?
Au cœur de la données personnelles définition globale, les données sensibles forment une catégorie spécifique. Leur traitement est, par principe, interdit en raison du risque élevé de discrimination qu’il comporte pour les individus concernés.
Ce sont des informations qui touchent au plus profond de l’identité, des croyances et de la vie privée d’une personne. Leur protection est donc maximale et elles représentent une catégorie particulière définie par la loi.
La liste des informations concernées
La loi dresse une liste précise des données considérées comme sensibles. Il est utile de les connaître pour bien repérer les informations sous haute surveillance. 📋
- L’origine raciale ou ethnique ;
- Les opinions politiques ;
- convictions religieuses ou philosophiques ;
- L’appartenance syndicale ;
- Les données génétiques et les données biométriques aux fins d’identifier une personne de manière unique ;
- Les données concernant la santé ;
- Les données concernant la vie sexuelle ou l’orientation sexuelle.
Un principe d’interdiction et ses exceptions
Le principe de base est simple : il est interdit de collecter et de traiter ces données. C’est une protection forte par défaut qui limite drastiquement l’accès à ces informations critiques.
Il existe toutefois des exceptions très strictes pour permettre le fonctionnement de certains services essentiels. Ces exceptions sont encadrées pour ne pas vider le principe de sa substance.
Les cas les plus fréquents incluent le consentement explicite de la personne, la sauvegarde de la vie humaine, ou un motif d’intérêt public important figurant parmi ces exceptions très strictes.
Cette catégorie obéit à un régime juridique propre, détaillé dans notre guide des données sensibles au sens du RGPD : liste officielle des catégories, interdiction de principe et exceptions.
Le cadre légal : pourquoi protéger nos informations est un enjeu majeur
Les autorités de contrôle : gardiens de la vie privée
Pour veiller au respect strict des règles, des autorités de contrôle indépendantes ont été spécialement créées. Elles agissent comme de véritables gendarmes de la donnée personnelle pour encadrer les pratiques. Leur mission est de surveiller l’application des lois 🛡️.
En France, cet organisme de référence est la CNIL (Commission Nationale de l’Informatique et des Libertés). Elle informe le public, conseille les professionnels et peut sanctionner sévèrement les organismes en infraction.
Au niveau européen, le CEPD (Contrôleur européen de la protection des données) assure la cohérence globale. Il harmonise l’action entre les différentes autorités nationales.
Transparence et confiance : les piliers du système
L’un des buts principaux de la réglementation est de bâtir une relation de confiance solide entre les individus et les organismes. Les utilisateurs doivent se sentir en sécurité face à ceux qui traitent leurs données 🤝.
Cette confiance repose entièrement sur la transparence des processus. Les organisations doivent informer clairement les personnes sur les données collectées, expliquer pourquoi elles le sont, et préciser pour combien de temps. C’est ici que la données personnelles définition prend tout son sens.
Sans cette transparence affichée, il est impossible pour un individu d’exercer ses droits. Il ne peut alors plus garder le contrôle sur ses informations.
Comprendre la culture numérique pour mieux se protéger
Au-delà des lois existantes, la meilleure protection reste la compréhension des enjeux actuels. Développer sa propre culture numérique est devenu indispensable pour naviguer sereinement en ligne. C’est le premier rempart contre les mauvaises surprises 💡.
Cela passe par l’éducation aux outils, la connaissance précise de ses droits et la capacité à repérer les situations à risque. Des ressources existent pour approfondir sa culture numérique et mieux comprendre les pratiques digitales.
Un droit en constante évolution
Le droit de la protection des données n’est jamais figé dans le temps. Il doit s’adapter en permanence aux nouvelles technologies comme l’intelligence artificielle (IA) et aux nouveaux usages. Cette flexibilité est nécessaire pour rester efficace ⚖️.
Des réflexions sont actuellement en cours, notamment au niveau européen, pour ajuster certaines définitions. Il s’agit de répondre concrètement aux défis technologiques émergents.
On peut citer l’exemple du projet d’ omnibus numérique qui pourrait faire évoluer la notion de donnée personnelle. Cela modifierait les règles dans certains contextes spécifiques.
Les grands principes du traitement des données
Des règles du jeu claires pour tous
Le RGPD fixe sept principes socles qui encadrent la définition des données personnelles et leur usage au quotidien. Ces directives agissent comme un véritable code de la route pour les structures, qu’il s’agisse d’entreprises privées ou d’administrations publiques. 🛡️
Appliquer ces règles ne relève pas du choix, mais de l’obligation légale stricte. C’est la responsabilité de chaque organisme de prouver, documentation à l’appui, que ces exigences sont respectées concrètement dans leurs processus internes.
Les sept piliers de la protection des données
Ces sept commandements fonctionnent ensemble pour assurer une gestion éthique et sécurisée des informations. Ils forment un tout indissociable pour protéger les droits des individus. Voici ce qu’il faut retenir. 👇
- Licéité, loyauté et transparence : Le traitement exige une base légale et une honnêteté totale.
- Limitation des finalités : Les données servent un objectif précis et légitime.
- Minimisation des données : On ne collecte que le strict nécessaire.
- Exactitude : Les informations doivent rester justes et à jour.
- Limitation de la conservation : Le stockage ne dure que le temps requis.
- Intégrité et confidentialité : La sécurité prévient pertes et accès non autorisés.
- Responsabilité (Accountability) : L’organisme doit prouver son respect des règles.
La minimisation : collecter juste ce qu’il faut
Le principe de minimisation des données impose une rigueur absolue aux collecteurs. Une organisation ne peut pas amasser des informations « au cas où » cela servirait plus tard. Chaque élément recueilli doit avoir une utilité immédiate et justifiée. 📉
Prenons un exemple concret pour illustrer. Pour s’inscrire à une newsletter, seule l’adresse e-mail est requise. Exiger la date de naissance ou l’adresse postale complète serait considéré comme excessif, intrusif et contraire à cette règle de sobriété.
La limitation de la conservation : une date de péremption pour les données
Abordons enfin la limitation de la conservation des fichiers. Les données personnelles ne peuvent pas dormir indéfiniment dans les serveurs. Elles possèdent virtuellement une « date d’expiration » au-delà de laquelle leur détention devient illégale pour l’organisme. ⏳
Cette durée de vie se définit selon l’objectif initial de la collecte. Dès que la finalité est atteinte, les fichiers doivent être impérativement supprimés ou anonymisés de manière irréversible, garantissant ainsi le droit à l’oubli numérique.
Les données personnelles, nouvel or noir de l’économie numérique
Si les données personnelles sont autant protégées, c’est aussi parce qu’elles ont acquis une valeur économique considérable. Elles sont devenues le carburant de nombreux modèles d’affaires sur internet. 💰
La valeur économique de l’information personnelle
Au-delà d’une simple données personnelles définition, ces informations représentent un actif immatériel stratégique pour de nombreuses entreprises. Elles sont souvent qualifiées d' »or noir du XXIe siècle » car elles constituent une ressource brute indispensable à l’économie numérique actuelle.
Cette valeur provient directement de leur capacité à permettre une personnalisation poussée des services, un ciblage publicitaire précis et une prise de décision optimisée pour les organisations.
Des entreprises entières, notamment dans le secteur de la publicité en ligne, ont bâti leur modèle économique exclusivement sur la collecte et l’analyse de ces données.
Le ciblage comportemental au cœur du modèle
Le ciblage comportemental consiste à analyser les actions d’un utilisateur, comme les sites visités ou les clics, pour déduire ses centres d’intérêt et lui présenter des publicités pertinentes. 🎯
C’est ce mécanisme technique qui explique pourquoi une recherche pour un produit sur un site A peut entraîner l’affichage de publicités pour ce même produit sur un site B.
Ce modèle finance une grande partie des services « gratuits » du web que nous utilisons quotidiennement.
Profilage et prise de décision automatisée
Le profilage va plus loin en utilisant des données pour évaluer certains aspects d’une personne, comme ses préférences, sa situation économique ou sa performance au travail. Il permet de classer les individus dans des catégories prédictives.
Ce profilage peut mener à une décision entièrement automatisée, comme l’octroi ou le refus d’un crédit en ligne, sans intervention humaine. Le RGPD encadre spécifiquement cette pratique pour éviter les dérives discriminatoires. ⚖️
Les enjeux de souveraineté numérique
La souveraineté numérique élargit la perspective au-delà de l’individu. La concentration massive de données par quelques grands acteurs technologiques pose des questions stratégiques majeures pour l’indépendance des États face aux géants du numérique.
La maîtrise des données des citoyens est devenue un enjeu de pouvoir économique et politique, ce qui explique en partie la volonté de l’Europe de réguler fortement ce secteur. 🇪🇺
Vos droits et les risques : maîtriser son identité numérique
Les droits essentiels des personnes concernées
Le RGPD arme les citoyens de plusieurs leviers juridiques pour garder le contrôle sur leur vie privée. Le socle de cette protection est le droit à l’information : il garantit de savoir qui collecte quoi, et pour quelle finalité précise, intégrant ainsi une données personnelles définition claire.
S’y ajoutent le droit d’accès, pour obtenir une copie de ses informations, le droit de rectification pour corriger une erreur, et le droit d’opposition. Ce dernier permet de refuser un traitement spécifique, notamment lorsqu’il vise des objectifs de prospection commerciale.
Ces mécanismes juridiques permettent de ne pas rester un simple spectateur passif face à la collecte massive de données 🛡️.
Le droit à l’effacement ou « droit à l’oubli »
On met souvent en avant le droit à l’effacement, médiatisé sous le nom de « droit à l’oubli ». Ce dispositif permet à tout individu de demander la suppression définitive de ses données personnelles auprès de l’organisme qui les détient.
Toutefois, ce droit n’est pas absolu et ne fonctionne pas sur simple demande. Il s’applique dans des cas précis, par exemple si les données ne sont plus nécessaires, si le consentement est retiré, ou si le traitement était illicite. C’est un point central du droit à l’effacement.
Le droit à la portabilité : reprendre ses billes
Introduit par le RGPD, le droit à la portabilité représente une avancée majeure pour l’utilisateur. Il offre la possibilité de récupérer l’ensemble de ses données dans un format structuré, couramment utilisé et lisible par une machine, comme du CSV.
L’objectif principal est de faciliter le changement de service, par exemple passer d’un réseau social à un autre, en emportant son historique avec soi. Cette mobilité numérique favorise une concurrence plus saine entre les différentes plateformes 🔄.
La violation de données : que se passe-t-il en cas d’incident ?
Une violation de données se définit comme un incident de sécurité avéré. Elle compromet la confidentialité, la disponibilité ou l’intégrité des informations, que ce soit par destruction, perte ou divulgation non autorisée.
Lorsque cette violation présente un risque pour les droits des personnes, l’organisme a l’obligation stricte de notifier l’autorité de contrôle compétente (la CNIL en France). Cette déclaration doit se faire dans un délai très court, généralement sous 72 heures.
Si le risque identifié est élevé pour la vie privée, l’organisme doit aussi informer directement les victimes de cette violation de données.
Quatre droits concrets méritent chacun un guide détaillé : le droit d’accès à vos données personnelles pour savoir ce qu’un organisme détient sur vous, la portabilité de vos données pour les récupérer et les transférer, le droit à l’oubli numérique pour faire effacer ce qui n’a plus lieu d’être, et la marche à suivre en cas de violation de données personnelles.
Comment protéger efficacement ses données personnelles au quotidien ?
Connaître ses droits constitue la première étape, mais adopter les bons réflexes s’avère tout aussi important pour limiter la dissémination des informations. Voici les actions concrètes à mettre en place pour sécuriser son espace numérique. ✍️
Gérer les paramètres de confidentialité
Le premier réflexe consiste à vérifier et configurer minutieusement les paramètres de confidentialité des services utilisés au quotidien : réseaux sociaux, applications mobiles ou navigateur web. Ces réglages déterminent précisément qui accède aux informations partagées en ligne.
Par défaut, ces paramètres restent souvent très permissifs sur la plupart des plateformes. Il est nécessaire de prendre le temps de les ajuster pour ne partager que le strict nécessaire et éviter les fuites.
L’utilisateur doit décider activement qui peut consulter ses publications, ses photos personnelles ou sa localisation en temps réel.
Utiliser des mots de passe robustes et uniques
La sécurité des comptes repose essentiellement sur la qualité des mots de passe choisis. Un code robuste se doit d’être long, complexe et ne doit contenir aucune information personnelle évidente comme une date de naissance pour garantir une protection optimale.
Il est surtout capital d’utiliser un mot de passe différent pour chaque service. En cas de fuite de données sur un site spécifique, les autres comptes ne seront pas compromis par une attaque en chaîne.
L’utilisation d’un gestionnaire de mots de passe est fortement recommandée pour gérer cette complexité technique et sécuriser les accès sans effort de mémorisation.
Être vigilant face au hameçonnage (phishing)
Le hameçonnage (ou phishing) est une technique frauduleuse visant à vous soutirer des informations confidentielles (identifiants, mots de passe, données bancaires) en se faisant passer pour un tiers de confiance, comme votre banque ou une administration. La vigilance est donc de mise.
Méfiez-vous des e-mails ou SMS inattendus, au ton alarmiste et contenant souvent des fautes d’orthographe. Ne jamais cliquer sur les liens suspects ni fournir d’informations confidentielles en réponse constitue la barrière de sécurité la plus efficace.
Réfléchir avant de donner son consentement
Lorsque vous installez une application ou vous inscrivez à un service, on vous demande souvent votre consentement pour accéder à vos contacts, votre localisation ou vos photos. C’est un point clé de la définition des données personnelles et de leur maîtrise.
Prenez un instant pour vous demander si cet accès est réellement justifié par la fonction du service. Une application de retouche photo a-t-elle vraiment besoin d’accéder à vos contacts ? Vous avez le droit de refuser pour protéger votre vie privée.
La maîtrise de ses données personnelles constitue un enjeu central de la citoyenneté numérique. Comprendre les définitions, identifier les risques et exercer ses droits permet de naviguer en toute confiance. Adopter ces réflexes de protection garantit une meilleure sécurité de son identité en ligne au quotidien. 🔐
Comment vos données sont collectées : les grands modes de collecte
Savoir ce qu’est une donnée personnelle ne dit pas encore comment elle arrive dans les bases des organisations. Trois grandes voies coexistent : la collecte directe, où vous transmettez l’information en toute conscience, la collecte indirecte, où votre activité la génère en arrière-plan, et la collecte déduite, où des algorithmes la fabriquent par recoupement. Chacun de ces canaux capte des familles d’informations différentes : notre panorama d’exemples de données personnelles les recense catégorie par catégorie, inutile donc d’en dresser la liste ici.
La collecte directe : vous transmettez l’information en connaissance de cause
Le formulaire web reste le canal le plus visible. Créer un compte client, s’inscrire à une lettre d’information ou finaliser une commande revient à remplir des champs dont vous identifiez clairement le destinataire. La logique est celle de l’échange : une information contre un service ou un produit.
Les sondages et questionnaires prolongent ce registre déclaratif. Ils recueillent des avis structurés, mesurent la satisfaction ou explorent des habitudes de consommation, par choix multiples ou champs libres, et fournissent aux organisations une lecture à la fois chiffrée et qualitative de leurs publics.
Dernier étage de cette collecte volontaire : les interactions ludiques. Quiz de personnalité, jeux-concours et tests de recommandation relèvent de ce que le marketing nomme la zero-party data, des informations que l’utilisateur partage proactivement en échange d’une expérience divertissante. Pour l’organisation, ce sont des données particulièrement qualifiées, obtenues sans aucun dispositif de pistage.
La collecte indirecte : vos traces captées en arrière-plan
La navigation génère des informations sans la moindre saisie de votre part. Les cookies, petits fichiers déposés sur l’appareil, mémorisent le passage d’un visiteur ; les pixels invisibles suivent l’activité d’une page à l’autre. Certains de ces traceurs sont strictement fonctionnels, comme la conservation d’un panier en cours ; d’autres servent la mesure d’audience ou la publicité, et c’est cette seconde famille qui concentre les débats.
Les outils d’analyse de fréquentation détaillent quant à eux les pages consultées, le temps passé, les parcours de clic et le type d’appareil utilisé. S’y ajoutent les données transactionnelles, ces registres générés automatiquement par chaque action : un achat validé, un téléchargement, une réservation. Leur accumulation permet de déduire des habitudes et d’anticiper des comportements futurs.
Les capteurs étendent enfin cette captation au monde physique : montres connectées, assistants vocaux, véhicules et électroménager intelligents transmettent en continu des mesures comportementales vers les serveurs de leurs fabricants.
La collecte déduite : ce que le profilage fabrique à partir du reste
Troisième mode, le plus discret : les données inférées. Personne ne vous les a demandées et aucune trace brute ne les contient ; un algorithme les déduit en croisant vos comportements avec d’autres sources, internes ou externes. Centres d’intérêt supposés, catégorie sociale probable, réceptivité estimée à tel message : ces déductions enrichissent le profil sans nouvelle collecte apparente.
Le moteur de l’ensemble est économique. Les services numériques collectent pour personnaliser les contenus, améliorer leurs produits et alimenter le ciblage publicitaire qui finance leur gratuité apparente, un modèle décrit plus haut dans la section consacrée à la valeur des données. Chaque interaction nourrit ce système, et c’est la raison pour laquelle le règlement exige un objectif déterminé et légitime pour toute collecte, quel que soit le mode employé.
Où sont stockées vos données : hébergement, localisation et cadre juridique
Une fois collectées, vos informations ne flottent pas dans un nuage abstrait : elles résident sur des serveurs bien réels, exploités par des hébergeurs. Les aspects techniques du stockage sont traités dans nos articles dédiés au stockage en ligne ; ce qui nous occupe ici relève du juridique : qui répond de ces données, et sous quelle loi elles vivent.
Hébergeur et responsable : une relation strictement encadrée
Le règlement européen distingue deux rôles. Le responsable du traitement décide du pourquoi et du comment ; l’hébergeur agit comme sous-traitant : il stocke sur instruction, sans jamais déterminer la finalité. Cette répartition doit être formalisée dans un contrat écrit qui fixe les obligations de chacun, notamment en matière de sécurité et d’alerte en cas d’instruction illégale.
Précision utile : le simple stockage passif constitue déjà un traitement au sens du règlement. Conserver un fichier engage les mêmes obligations que le collecter, ce qui place l’hébergement au cœur de la conformité et non à sa périphérie.
Certains secteurs ajoutent une couche d’exigence. En France, un prestataire externe doit détenir la certification HDS, pour hébergeur de données de santé, avant de pouvoir stocker ce type d’informations à caractère personnel. Le niveau de protection requis suit donc la sensibilité de ce qui est confié aux serveurs.
Localisation, transferts hors Union européenne et souveraineté
L’emplacement géographique des serveurs n’a rien d’un détail logistique : il détermine le droit applicable. Le sujet concerne directement le grand public, car messageries, réseaux sociaux et espaces de sauvegarde répliquent les informations de leurs utilisateurs dans des centres de données répartis sur plusieurs continents, sans que cette géographie soit jamais visible à l’écran. Des données hébergées dans l’Union européenne restent sous la protection directe du RGPD. Dès qu’elles en sortent, le transfert devient une opération juridique encadrée.
Deux mécanismes principaux sécurisent ces flux. Les décisions d’adéquation, d’abord : la Commission européenne reconnaît que certains pays offrent une protection comparable, et les données y circulent alors librement. Les clauses contractuelles types, ensuite : des modèles de contrat qui engagent le destinataire étranger à respecter les standards européens, faute de quoi le transfert s’expose à la sanction.
Reste une zone de friction. Des législations extraterritoriales, comme le Cloud Act américain, peuvent autoriser des autorités étrangères à accéder aux données détenues par leurs prestataires nationaux, y compris lorsqu’elles sont stockées pour le compte d’organisations européennes. Cette tension entre régimes juridiques donne un contenu très concret à la souveraineté numérique évoquée plus haut : choisir où vivent ses données, c’est choisir qui peut, en dernier ressort, y accéder.
Enjeux et risques : ce que la circulation de vos données implique
Collectées puis stockées, vos informations circulent : elles sont croisées, parfois revendues, parfois volées. Dresser la typologie de ce qui peut mal tourner aide à mesurer ce que cette circulation implique, pour chacun comme pour la collectivité.
Les risques individuels : fuite, usurpation, profilage abusif
La fuite de données constitue le point de départ de la plupart des dérives. La cybercriminalité s’est industrialisée : des groupes structurés, motivés par la rentabilité, visent les organisations qui concentrent de gros volumes d’informations. Identités complètes et dossiers médicaux s’y négocient ensuite comme des marchandises sur le dark web. Les rançongiciels ajoutent la double extorsion : les fichiers sont chiffrés, puis leur publication est brandie comme menace si la rançon n’est pas réglée.
Pour la personne concernée, les conséquences s’enchaînent en cascade : usurpation d’identité permettant d’ouvrir des comptes ou des crédits à son nom, fraude bancaire, hameçonnage rendu plus crédible par les informations contextuelles dérobées, chantage à la divulgation. L’effet domino joue à plein, les identifiants volés étant testés sur d’autres plateformes.
Le profilage abusif représente un risque plus silencieux. Le classement algorithmique des individus peut aboutir à des refus de crédit, d’assurance ou d’emploi, prononcés sans explication ni recours visible. Cette opacité transforme un tri statistique en discrimination concrète.
Les enjeux collectifs : asymétrie de pouvoir et économie de l’attention
Au-delà des préjudices individuels, la circulation massive des données déséquilibre la relation entre plateformes et utilisateurs. D’un côté, des ressources techniques et juridiques colossales ; de l’autre, un internaute sans visibilité réelle sur le traitement de ses informations. Le consentement s’en trouve biaisé : selon une enquête de l’IFOP pour la CNIL, 65 % des personnes acceptent les traceurs par lassitude.
Cette asymétrie nourrit l’économie de l’attention. La gratuité apparente des services se paie en attention captée et en traces exploitables, et le sentiment d’être observé finit par modifier les comportements eux-mêmes. Les chercheurs décrivent un effet paralysant : on s’autocensure, on renonce à certaines recherches, et l’autonomie de la pensée s’érode.
Le micro-ciblage pousse cette logique jusqu’à la manipulation : des messages taillés sur mesure, diffusés hors de toute contradiction publique, fragmentent le débat collectif. La question dépasse alors la vie privée de chacun pour toucher la qualité même de la délibération démocratique.
Identifier ces risques est une chose, s’en prémunir en est une autre : les mesures concrètes à adopter font l’objet d’un guide dédié pour protéger ses données au quotidien.
La question du stockage de ces données est indissociable de leur protection : savoir où et comment elles sont conservées conditionne leur sécurité.
❓ Questions fréquentes
Cette expression désigne toute information se rapportant à une personne physique identifiée ou identifiable. Concrètement, cela signifie que dès qu’une donnée permet, seule ou croisée avec d’autres, de reconnaître un individu précis, elle entre dans ce cadre légal. L’objectif de cette définition est de protéger la vie privée et de garantir à chacun la maîtrise de son identité numérique 🔐.
Le spectre des données personnelles est très large et dépasse les simples informations d’état civil. Il inclut évidemment le nom, le prénom ou l’adresse, mais s’étend aux traces numériques comme l’adresse IP, l’historique de navigation ou les identifiants publicitaires. Des éléments physiques comme une photographie, un enregistrement vocal ou des empreintes digitales font également partie de cette liste 📍.
On distingue principalement les données d’identification directe (nom, prénom) des données d’identification indirecte, qui nécessitent un recoupement pour retrouver la personne (numéro de téléphone, matricule). Il existe également une catégorie spécifique appelée « données sensibles« , regroupant des informations intimes comme l’état de santé, les opinions politiques ou l’orientation sexuelle, qui bénéficient d’une protection juridique renforcée 🛡️.
Oui, un numéro de compte, un IBAN ou un numéro de carte bancaire constituent bien des données personnelles. Bien qu’il s’agisse de séries de chiffres, ces informations sont directement rattachées à un titulaire identifié par l’établissement financier. Leur traitement est strictement encadré, notamment pour prévenir les risques de fraude et sécuriser les transactions économiques 💳.